10月24日凌晨,月之暗面发布新一代开源大模型Kimi K3.1 Pro。3万亿级参数规模,100万词元上下文窗口,蝉联全球参数规模最大的开源模型。几乎同一时间,另一组数据也在流传:根据OpenRouter统计,2026年10月12日至18日当周,中国大模型周调用量达79.18万亿Token,美国为17.36万亿Token,中国连续25周超过美国,当周全球调用量前五名全部是中国模型。
两个“第一”放在一起,很容易被读成一句简单的结论。但它们衡量的其实是两件不同的事:一个是模型能装下多少,另一个是模型被用了多少。两个数字都有真实的产业含义,也都各有各的“不能说明”。
Kimi K3.1 Pro的3万亿:参数第一,不等于能力第一
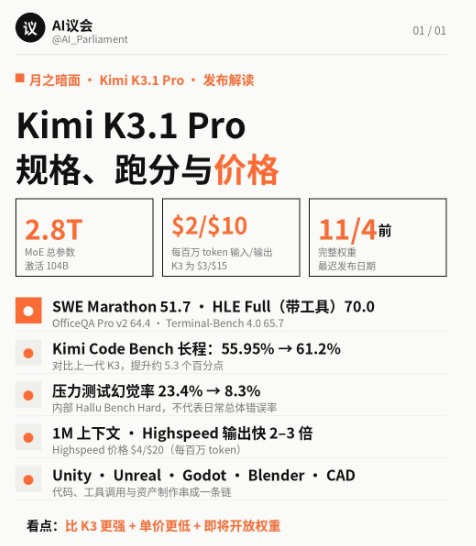
先看参数。Kimi K3.1 Pro的3万亿级规模,是在上一代Kimi K3(2.8万亿参数)基础上的升级。月之暗面大幅增加了后训练算力,官方表述是“参数规模增大,意味着模型能把更多知识和规律装进‘脑子’”。在能力提升上,重点落在代码、3D创作、金融研究和长程Agent场景。
国际评测的结果值得注意。在Office QA Pro v2和SpreadsheetBench v2两项测评中,Kimi K3.1 Pro取得全球最佳成绩,超过Opus 5.5、Fable 5.1和GPT-6 Astra等闭源模型。在Terminal-Bench 4.0编程测试中,K3.1 Pro得分65.7%,高于GPT-6 Astra的58.2%,距离Claude Opus 5.5的66.4%仅差0.7个百分点。Artificial Analysis智能指数上,K3.1 Pro拿到55分,排名全球第四,落后榜首Claude Opus 5.5仅3分。价格方面,据称仅为GPT-6 Astra的五分之一。
这些数据勾勒出一个更准确的图景:参数规模全球第一是事实,但“第一”的限定词是“开源模型”。 在整体模型能力上,K3.1 Pro接近前沿闭源模型,但尚未超越最强闭源模型。真正有产业意义的组合是“接近前沿的性能+开源+显著更低的价格”——这个组合让需要本地部署、数据可控或成本敏感的团队有了一个此前不太存在的选项。
参数规模本身也不是能力保证。把更多参数装进模型,增加的是容量上限,能否把这个容量转化成可靠的推理和任务表现,取决于数据质量、训练方法和后训练策略。3万亿参数的意义,在于它证明了中国团队在超大规模模型训练工程上具备了持续迭代的能力,而不在于“数字最大所以最强”。
79万亿Token的25周:调用量第一,不等于收入第一
再看调用量。OpenRouter的数据口径需要先说清楚:它是全球主流的AI API聚合平台,统计的是开发者通过该平台产生的Token调用量,不是模型厂商的全部收入,也不是模型能力的直接排名。在这个平台上,中国模型的周调用量已经连续25周超过美国,当周79.18万亿Token的规模约为美国的四倍半,占全球总量的48.3%。
这个数据的价值在于,它衡量的是真实生产环境中的使用规模。跑分可以优化,演示可以挑选场景,但每周几十万亿Token的调用量意味着这些模型正在电商客服、内容生成、代码辅助、翻译等场景中持续承载真实业务。当周调用量前五名全部是中国模型:DeepSeek V4.1 Flash以32.8万亿Token连续两周居首,智谱GLM 5.3 Flash为12.2万亿,阶跃星辰Step 5 Preview为11.5万亿。
中国模型在这个平台上被大量选择,有几个可解释的原因。成本是首要因素:中国模型的使用成本远低于美国同类模型,在大部分场景中性能差距已经缩小到开发者难以感知的程度时,价格成为决定性变量。其次是工程化能力:API稳定性、上下文窗口、工具调用和容错率这些“不性感但致命”的细节,决定了模型能不能在生产线上持续运行。第三是开源生态:多款中国模型提供可下载、可本地部署的开放权重版本,降低了供应商锁定和数据合规方面的顾虑。
但调用量第一有一个必须直视的“另一面”。有分析指出,OpenRouter上相当一部分调用来自低成本甚至免费模式的批量请求,高调用量并未同步转化为头部厂商的高收入。低价策略扩大了使用规模,也在挤压模型厂商的利润空间。“被用得最多”和“赚得最多”之间,隔着一整套尚未解决的变现机制。 调用量领先说明中国模型在应用渗透和性价比竞争上占据了有利位置,但它不能直接推导出中国AI产业在底层技术或商业回报上已经全面领先。
两个“第一”放在一起,真正的信号是什么
分开看,两个数字各有边界。合在一起看,它们指向一个更具体的判断:中美AI竞争的维度正在分化。
美国模型在底层架构创新和前沿能力探索上仍然保持引领,GPT系列和Claude系列在最高能力段位上依然是参照系。中国模型的优势则更多出现在“被大规模使用”这一层:把接近前沿的能力以开源或低价的方式交付出去,在真实业务场景中积累调用规模和工程经验。这不是“谁更强”的单线答案,而是两条能力曲线在不同位置上各自展开。
对正在做模型选型的团队来说,这两个数据给出的实用信息比“谁第一”更有价值。如果一个任务对绝对能力上限要求极高,闭源前沿模型仍然是最直接的选择;如果任务对成本、数据可控性和部署灵活性更敏感,且性能需求落在“接近前沿”的区间内,Kimi K3.1 Pro所代表的“开源+接近前沿性能+低价”组合就构成了一个值得认真评估的选项。调用量榜单上的分布也在提示另一件事:大量企业已经在用实际调用行为做出选择,选型时参考“别人在生产环境里用什么”,比只看跑分更接近真实。
总结
Kimi K3.1 Pro的3万亿参数蝉联全球最大开源模型,是事实;中国大模型周调用量连续25周超过美国,也是事实。但第一个“第一”限定在开源模型和参数规模,第二个“第一”衡量的是特定平台上的使用规模而非收入或绝对能力。两个数字放在一起,说明的是中国大模型在“规模化被使用”这一维度上建立起了可观察的优势,而这一优势能否转化为可持续的商业回报和底层技术积累,是比周榜排名更值得长期关注的问题。
CTA
如果你正在评估开源模型与闭源模型的选型边界,收藏本文作为团队讨论的参考框架,或留言说明你的场景类型与成本约束,后续可以围绕“接近前沿性能”在具体任务中的实际表现继续展开。
4. FAQ
Q1:Kimi K3.1 Pro是全球最强的开源模型吗?
“最大”和“最强”是两个不同的判断。Kimi K3.1 Pro的3万亿级参数使其成为全球参数规模最大的开源模型,在多项评测中综合智能水平接近领先闭源模型,部分任务(如Office QA Pro v2、SpreadsheetBench v2)取得全球最佳成绩。但在整体智能指数的绝对排名上,它仍落后于顶尖闭源模型,尚未在“最强”这个维度上完成超越。
Q2:周调用量连续25周超过美国,是否意味着中国大模型整体领先美国?
调用量衡量的是OpenRouter平台上的使用规模,反映的是开发者用实际调用做出的选择,尤其在成本敏感和工程化需求驱动的场景中。它说明中国模型在“被大规模使用”这一层具有优势,但不能直接等同于底层原始创新能力、最高能力段位或商业收入的全面领先。两个维度需要分开看。
Q3:OpenRouter的调用量数据统计口径是什么?
OpenRouter是全球主流的AI API聚合平台,统计的是开发者通过该平台产生的Token调用量。平台实行零加价策略,按Token计数而非独立请求次数,并支持BYOK(自带Key)和免费额度模式,因此数据主要反映平台上开发者的真实选择偏好,而非全市场模型厂商的总调用量或总收入。
Q4:高调用量对中国大模型厂商意味着高收入吗?
不一定。有分析指出,当前相当一部分调用来自低价或免费模式的批量请求,调用量增长与收入增长之间存在明显缺口。低价策略有助于快速扩大使用规模、锁定企业客户,但也压缩了模型厂商的利润空间,变现模式仍是尚未解决的行业性问题。